AI Native Zone 建起来了,怎样让它运转?
从 Meta 的组织第二大脑,看知识、分析流程、评估与持续改进怎样让 Agent 承担更完整的专业工作。
AI Native Company #02
上一篇,我们提出:传统企业可以先选择一个具体项目,建立小型跨职能团队,给予有限但真实的自主权,让新的工作方式跑起来。
但团队坐到一起之后,工作怎样改变?如果专家仍然逐项分析、逐单判断,Agent 只是帮助查资料、写报告,这个 Zone 能释放的能力仍然有限。
进一步的问题是:怎样让 Agent 承担越来越完整的专业工作?
Meta 最近介绍的“组织第二大脑”,提供了一个方向:将知识系统、推理流程、评估框架和持续改进连接起来,让 Agent 的工作有依据、有方法,也能被检验和修正。(Meta 工程博客,2026 年 9 月 2 日)
知识,决定 Agent 依据什么工作
Knowledge System 要让 Agent 能够使用企业自己的定义、规则、立场和适用边界。
对传统企业,这意味着整理那些过去需要“找某个人问一下”才能获得的依据:哪些是正式规则,哪些只是惯例,哪些情况允许例外。
这个过程也在建立 Zone 的新规则。Agent 获得的授权,必须对应清楚的工作条件。
Recipe,让专业方法成为可执行的过程
知道规则之后,还需要知道怎样完成分析。Meta 用 recipe 组织多步骤流程,明确每一步检查什么、加载哪些知识,以及怎样才算完成;多个 recipe 可以组合,按阶段提供所需信息。(知识与推理架构)
以采购评估为例,可以设想这样的流程:确认采购用途,判断审查范围,收集证据,分项分析,最后汇总风险与未决问题。这只是理解机制的示意,并非 Meta 的实际流程。
采购标准属于知识;先确认什么、再怎样判断,属于 recipe。两者分开,政策调整时可以更新依据,分析遗漏时可以检查方法。
专家的工作由此变得可以拆解。哪些步骤能够交给 Agent,前后需要交付什么,哪里必须由人介入,都可以逐项设计。
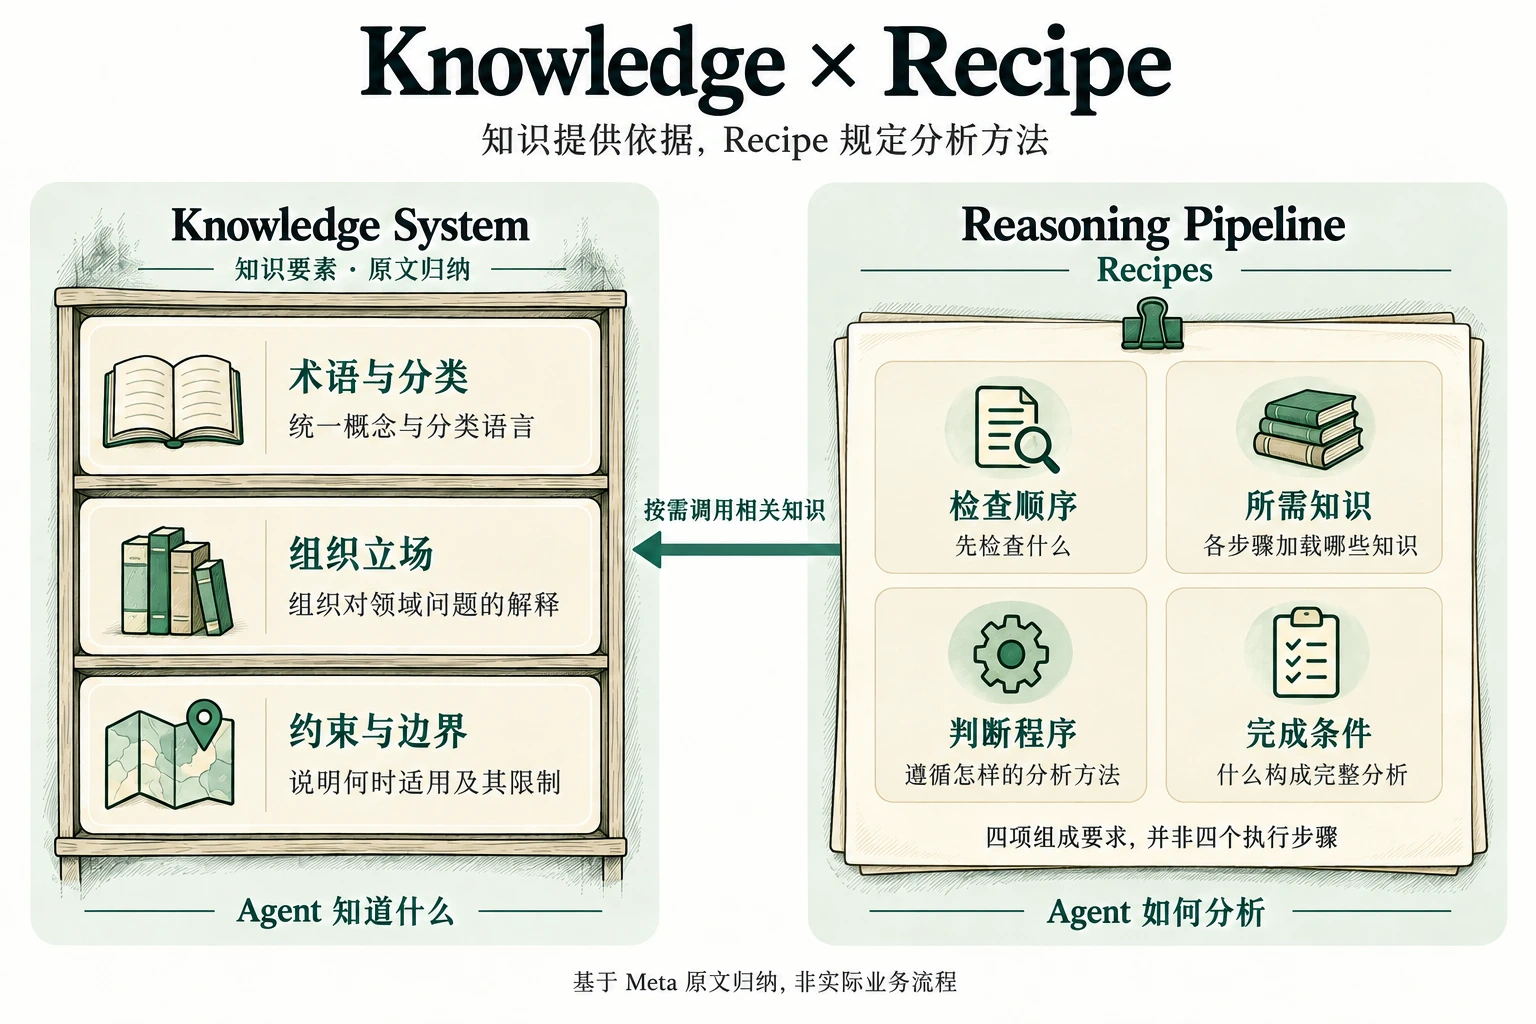
知识与方法的关系示意。点击图片查看大图。
但流程写出来,只是起点。它是否有效,还需要另外两层系统回答。
评估,决定哪些工作可以放心交出去
Evaluation Framework 应当把“做得好”变成可以检查的标准。
正常案例能否完成?边界情况能否识别?信息不足时会不会贸然下结论?如果每份结果仍需专家从头重做一遍,节省的劳动就很有限。
对 Zone 的设计而言,评估可以作为逐步扩大授权的依据。哪些任务继续复核,哪些可以减少人工介入,应当随着实际表现调整。这是本文的延伸建议;Meta 的实践仍在分析过程中设置人工检查点,遇到歧义时交由专家判断。
改进,让一次纠正改变后续工作
发现错误后,还需要区分:知识缺失、分析步骤有问题,还是问题本身存在分歧?
Self-Improvement Loop 要把这些反馈转成具体修改,再检查修复是否有效、是否影响其他场景。Meta 的系统保留了验证和人工审核,并把修复案例加入后续测试。(反馈与更新机制)
这里更新的是知识文件与 recipe,不需要重新训练底层模型。
这样,专家的纠正才有机会减少下一次人工介入,而非停留在一次对话里。
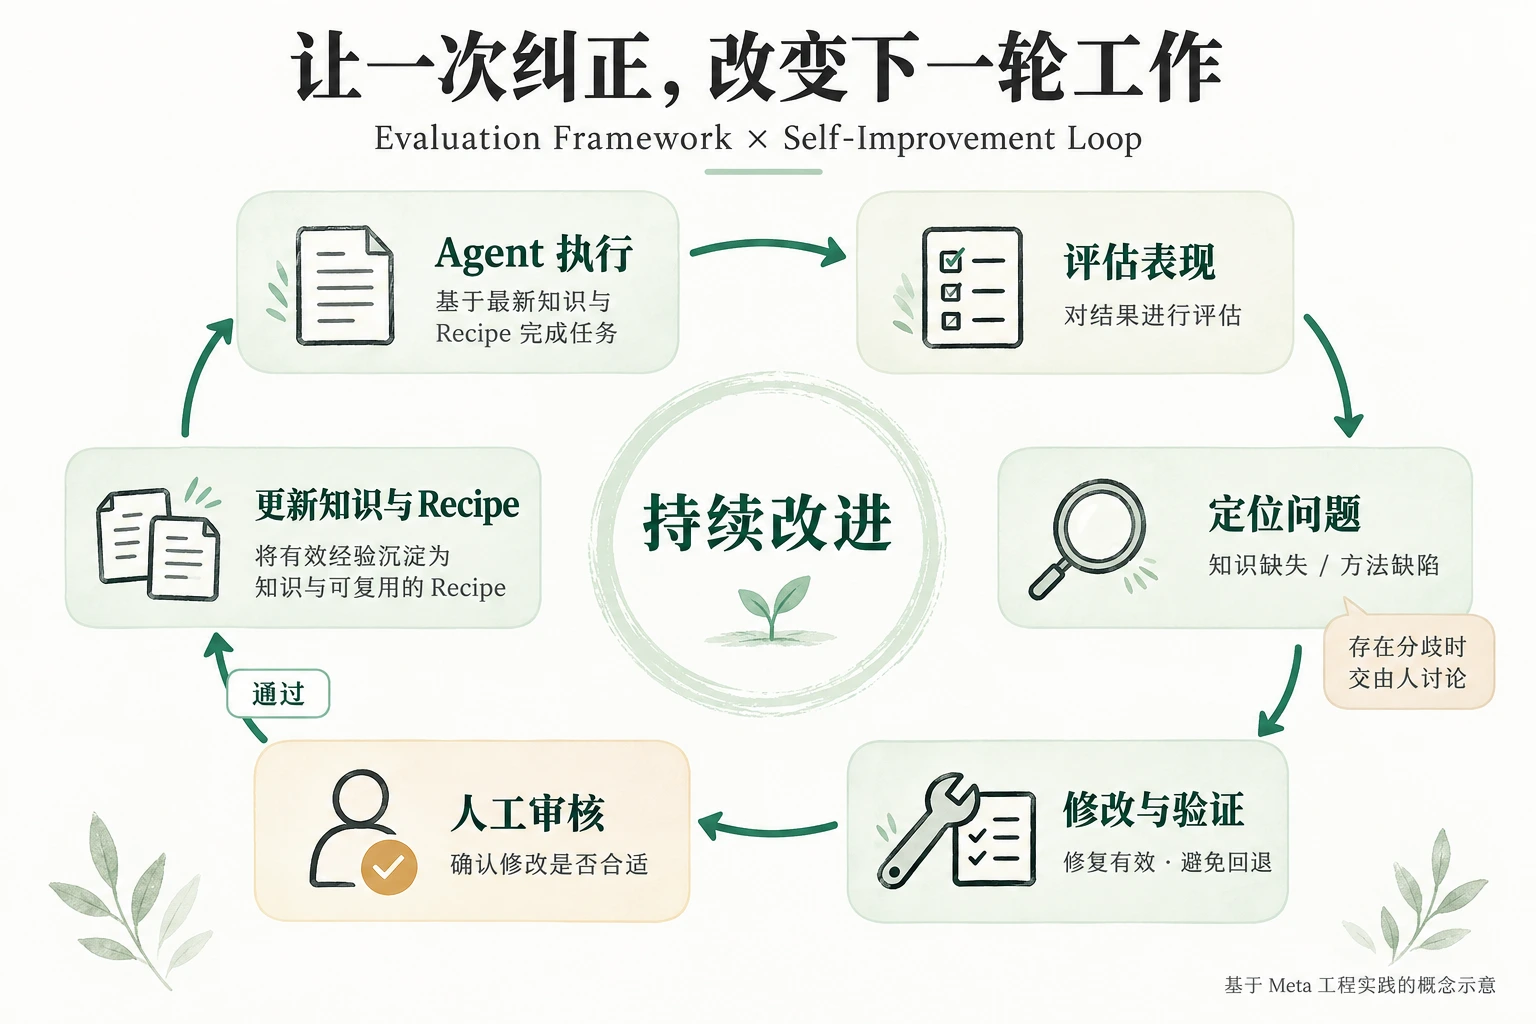
持续改进的概念示意。点击图片查看大图。
四层系统由此形成循环:知识提供依据,recipe 组织行动,评估检查表现,改进更新知识与方法。
对传统企业,目标可以是逐步让 Agent 接管更多专家原本需要完成的分析与执行,同时让专家转向规则设计、复杂例外和质量控制。Meta 的案例仍保留人的最终控制,不能据此推断专家岗位可以整体取消。
衡量 AI Native Zone 的进展,可以看一件事:经过验证后,Agent 能独立承担的工作,是否越来越完整?
本文三张配图均为 AI 生成的编辑配图,并非 Meta 官方图或实际办公室照片。
不想错过下一篇
新文章发布时发一封邮件到你的信箱。没有广告,可随时退订。
也可以用 RSS /rss.xml